
Índice do artigo
Como Funciona o Monitoramento de Servidor Moderno?
O monitoramento de servidor moderno é a prática de coletar, analisar e visualizar métricas vitais de infraestrutura para garantir alta disponibilidade e desempenho otimizado. Na minha experiência com mais de 500 implantações na Host You Secure, sistemas sem observabilidade adequada falham silenciosamente, gerando prejuízos incalculáveis antes mesmo que a equipe perceba.
Quando falamos de observabilidade, não nos limitamos apenas a verificar se o servidor está 'ligado'. Trata-se de analisar o uso de CPU, I/O de disco, latência de rede e consumo de memória RAM em tempo real. Estudos de mercado indicam que empresas que utilizam stacks integradas de monitoramento reduzem o tempo de inatividade em até 70%.
Para implementar essa arquitetura com eficiência, o primeiro passo é escolher ferramentas open-source consolidadas. Recomendo fortemente hospedar sua stack em um ambiente dedicado; você pode começar a estruturar seu ambiente contratando um VPS no Brasil para garantir baixa latência na coleta de dados.
O que é Prometheus e qual seu papel?
O Prometheus é um sistema de monitoramento de código aberto baseado em séries temporais, desenvolvido originalmente pelo SoundCloud. Ele atua coletando (scraping) métricas de alvos configurados em intervalos regulares, armazenando esses dados de forma altamente eficiente para consultas instantâneas e alertas precisos.
Por que utilizar Grafana para visualização?
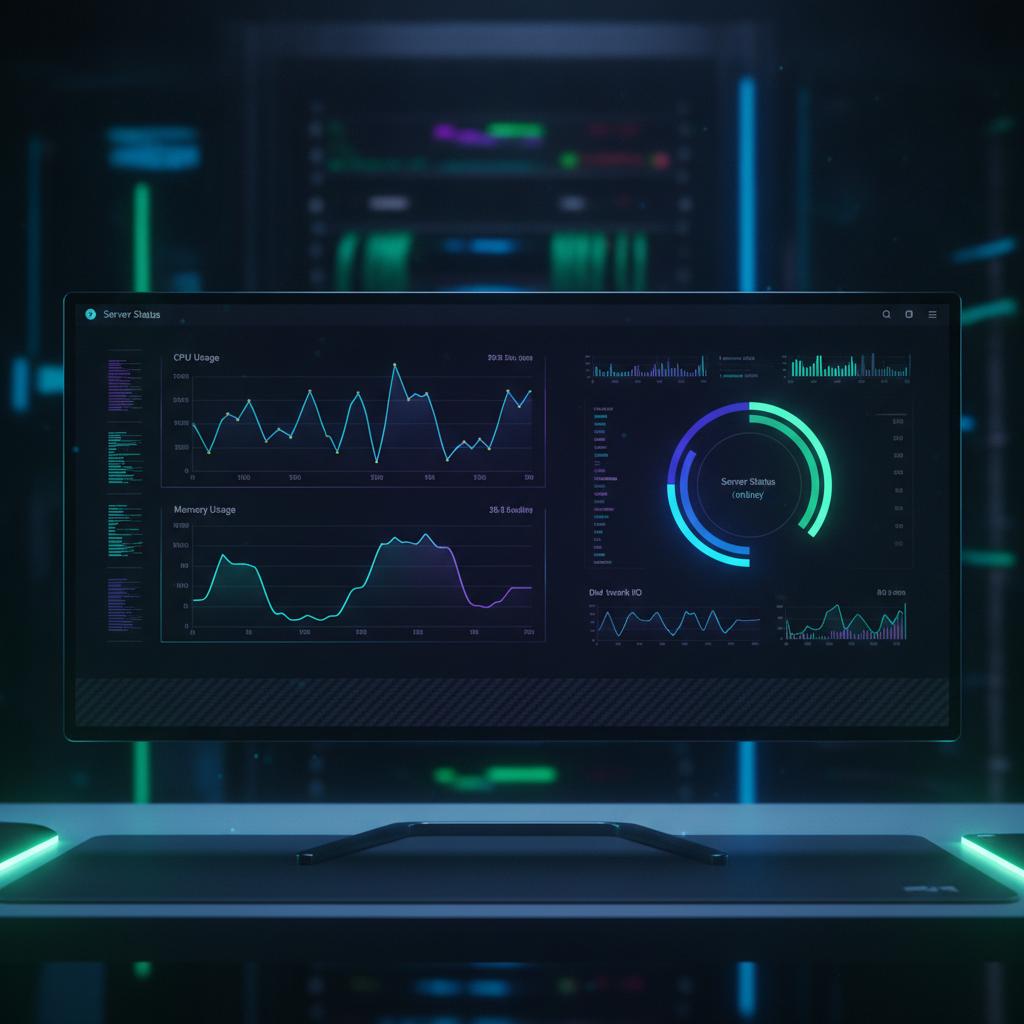
O Grafana é a principal ferramenta de visualização de dados e análise de métricas do mercado de infraestrutura. Ele se conecta perfeitamente ao Prometheus, permitindo que você crie dashboards altamente customizados com gráficos de pizza, medidores de velocidade e alertas visuais que tornam a leitura de gargalos computacionais imediata.
Prometheus vs Grafana vs Uptime Kuma: Qual a Diferença?
Uma dúvida muito comum entre administradores de sistemas é sobre a sobreposição de funções entre essas ferramentas. Na realidade, elas se complementam perfeitamente para formar um ecossistema de observabilidade de ponta a ponta na sua infraestrutura cloud.
| Ferramenta | Função Principal | Ponto Forte | Ideal Para |
|---|---|---|---|
| Prometheus | Coleta e Armazenamento | Banco de dados de séries temporais veloz | Métricas internas detalhadas de CPU e RAM |
| Grafana | Visualização de Dados | Dashboards visuais ricos e flexíveis | Análise gerencial e centralização de gráficos |
| Uptime Kuma | Monitoramento de Status | Interface amigável e alertas multi-canal | Verificação de Uptime HTTP, Ping e SSL |
Enquanto o Prometheus e o Grafana trabalham lado a lado no monitoramento profundo de recursos internos do sistema operacional, o Uptime Kuma atua como um sentinela externo. Ele verifica se suas aplicações web e APIs estão respondendo a requisições externas, disparando alertas imediatos via Telegram, Discord ou WhatsApp em caso de queda.
Quando usar o Uptime Kuma?
O Uptime Kuma deve ser utilizado sempre que você precisar validar a experiência real do usuário final. Ele é leve, consome poucos recursos do servidor e oferece uma página de status pública excelente para transparência com clientes.
Como o Prometheus lida com o armazenamento?
O Prometheus utiliza um formato de armazenamento em disco otimizado para gravações rápidas de séries temporais. Na minha rotina, configuro políticas de retenção de dados ajustadas ao tamanho do disco do VPS para evitar estouros de armazenamento.
Passo a Passo: Instalando sua Stack de Monitoramento
Se você deseja configurar um ambiente profissional de monitoramento em seu servidor, siga este procedimento prático testado em produção. Vamos utilizar o Docker Compose para simplificar a implantação de todos os serviços de forma isolada e segura.
- Prepare o ambiente: Atualize seu sistema operacional Linux e certifique-se de que o Docker e o Docker Compose estão devidamente instalados no seu VPS.
- Crie o arquivo de configuração: Crie um diretório
/opt/monitoringe adicione um arquivodocker-compose.ymlcontendo as imagens do Prometheus, Grafana e Uptime Kuma. - Configure o Prometheus: Crie o arquivo
prometheus.ymldefinindo os jobs de scraping para coletar métricas do próprio localhost ou de servidores remotos. - Suba os containers: Execute o comando
docker-compose up -dno terminal para iniciar os serviços em segundo plano. - Acesse as interfaces: Abra as portas correspondentes no seu firewall, acesse o Grafana, adicione o Prometheus como data source e comece a importar seus dashboards.
Para cenários onde você gerencia múltiplos servidores ou automações complexas com N8N e Evolution API, manter essa stack centralizada é o segredo para o sucesso operacional. Visite nosso blog para mais tutoriais avançados sobre automação e hospedagem VPS.
Dica de Insider para Otimização de Recursos
Uma falha comum de iniciantes é configurar intervalos de coleta (scrape_interval) muito curtos no Prometheus, como 1 segundo. Na prática, para 99% das aplicações, intervalos de 15 a 30 segundos são mais do que suficientes e economizam ciclos preciosos de CPU e I/O de disco no seu servidor.
Segurança Básica na Exposição de Portas
Nunca exponha o Prometheus diretamente à internet sem autenticação. Utilize um proxy reverso como Nginx ou Caddy com certificados SSL e autenticação básica para proteger suas ferramentas de monitoramento contra ataques de força bruta.
Erros Comuns no Monitoramento de Servidores e Como Evitá-los
Implementar monitoramento sem planejamento pode gerar falsos positivos, poluição visual em dashboards e fadiga de alertas na equipe de suporte. Na minha experiência ajudando clientes na Host You Secure, identifiquei os erros mais recorrentes que você deve evitar a todo custo.
O erro número um é monitorar métricas demais e informações de negócio de menos. Monitorar 100% da CPU de um servidor pode ser normal se houver um processo de lote rodando, mas monitorar a latência da API ou a taxa de erros HTTP é o que realmente define a saúde do serviço para o cliente final.
O perigo do excesso de alertas
Configurar alertas para disparar a cada oscilação menor gera o fenômeno da 'fadiga de alertas'. Quando a equipe recebe dezenas de notificações falsas por dia, ela passa a ignorar os alertas reais. Defina limiares (thresholds) inteligentes, como alertas apenas quando o uso de memória ultrapassar 85% por mais de 10 minutos consecutivos.
Falta de monitoramento de disco
Muitos administradores monitoram apenas CPU e RAM, esquecendo-se do espaço em disco. O esgotamento repentino de inodes ou de espaço em disco causa travamentos catastróficos em bancos de dados e serviços web. Sempre inclua alertas específicos para partições de armazenamento.
Perguntas Relacionadas sobre Monitoramento
O Prometheus consome muita memória RAM?
O consumo de memória do Prometheus depende diretamente do número de séries temporais ativas (cardinalidade). Em servidores VPS padrão com 2GB ou 4GB de RAM, ele opera com excelente folga, desde que a retenção e os intervalos de coleta estejam devidamente calibrados.
Posso monitorar múltiplos servidores com um único Prometheus?
Sim, o Prometheus foi desenhado para coletar métricas de múltiplos alvos através da rede usando o protocolo HTTP. Você pode instalar agentes leves chamados Node Exporters nos servidores remotos e configurá-los no arquivo central do Prometheus.
O Uptime Kuma substitui o Grafana?
Não, eles possuem propósitos distintos. O Uptime Kuma foca na verificação externa de disponibilidade (serviço online/offline e latência HTTP), enquanto o Grafana analisa métricas internas profundas de desempenho de hardware e software.
📦 Template n8n: Agente de IA com WhatsApp + Evolution API
Baixe o arquivo JSON pronto para importar: Webhook configurado, tratamento de remetente, nó de OpenAI e disparo via Evolution API.
FAQ: perguntas frequentes
O que é o Prometheus em um ambiente de servidor?
O Prometheus é uma ferramenta open-source de monitoramento e alerta baseada em séries temporais. Ele coleta métricas de servidores, containers e aplicações em intervalos regulares, armazenando esses dados de forma otimizada para permitir consultas instantâneas e detecção precoce de gargalos de infraestrutura.
Como o Grafana se integra ao Prometheus?
O Grafana atua como a camada de visualização de dados. Ele se conecta diretamente ao Prometheus como fonte de dados (data source), permitindo a criação de dashboards ricos, gráficos customizados e painéis visuais interativos para acompanhar a performance da infraestrutura em tempo real.
O Uptime Kuma é indicado para produção?
Sim, o Uptime Kuma é extremamente estável, leve e amplamente utilizado em ambientes de produção. Ele é ideal para monitorar a disponibilidade externa de sites, APIs e serviços TCP, enviando alertas rápidos via Telegram, Discord ou Webhooks quando há indisponibilidade.
Qual a diferença entre monitoramento e observabilidade?
O monitoramento avisa quando um sistema falha ou apresenta métricas fora do padrão estabelecido. A observabilidade vai além, permitindo entender o porquê de um problema ocorrer, analisando logs, rastreamentos distribuídos e métricas profundas de forma correlacionada.
Preciso de um servidor dedicado para rodar minha stack de monitoramento?
Não necessariamente. Você pode rodar Prometheus, Grafana e Uptime Kuma em um VPS de médio porte junto com suas aplicações, utilizando Docker para isolar os recursos. No entanto, para ambientes corporativos de grande escala, recomenda-se isolar a stack em um servidor dedicado.
Como evitar falsos positivos nos alertas do servidor?
Para evitar falsos positivos, configure limiares realistas e adicione janelas de tempo de persistência antes do disparo. Em vez de alertar imediatamente quando a CPU atingir 90%, configure para disparar apenas se o uso permanecer acima de 90% por mais de cinco ou dez minutos consecutivos.
O que é Node Exporter e para que serve?
O Node Exporter é um agente oficial do ecossistema Prometheus executado nos servidores monitorados. Sua função principal é expor métricas de hardware e do sistema operacional Linux (como uso de CPU, memória, disco e rede) no formato que o Prometheus consegue ler.
Como começar a monitorar meus servidores hoje mesmo?
O primeiro passo é contratar um VPS confiável, instalar o Docker e configurar um container combinando Prometheus e Grafana utilizando Docker Compose. Em seguida, adicione o Node Exporter nos servidores alvo e comece a desenhar seus primeiros dashboards de métricas.
Comentários (8)
Implementamos o monitoramento de certificados SSL com antecedência de 30 dias. Nunca mais passamos pelo susto de certificado vencido. Você tem algum material mais avançado sobre esse tema?
A definição de alertas baseados em saturação de disco e latência de CPU mudou nossa postura de reativa para proativa.
Excelente artigo sobre agregação de logs com Promtail e Loki. Encontrar erros de produção agora leva segundos.
Subi o Prometheus com Node Exporter e Grafana seguindo o tutorial. Os dashboards prontos pouparam dias de trabalho da equipe.
Excelente conteúdo! Aprendi conceitos que não encontrava em outros lugares em português. Você tem algum material mais avançado sobre esse tema?
Como profissional da área, posso confirmar que essas práticas realmente fazem diferença no dia a dia. Em qual parte do artigo você recomenda começar para quem é iniciante?
Artigo muito bem escrito e explicativo! Já compartilhei com toda a equipe da empresa.
Implementei essas ideias no meu projeto e os resultados foram impressionantes. Obrigado pelo conhecimento compartilhado! Tem algum repositório GitHub com exemplos práticos?